Niet iedereen antwoordt op je HR-survey: hoe voorkom je vertekende resultaten?
16.11.2026Stel: je organisatie telt 500 medewerkers en je organiseert een engagementbevraging. Uiteindelijk vullen 150 medewerkers de survey in. Een mooie respons, maar wanneer je de resultaten bekijkt, valt iets op: 80% van de respondenten zijn bedienden, terwijl die groep maar 55% van je personeelsbestand uitmaakt. Arbeiders zijn dus duidelijk ondervertegenwoordigd.
Kan je de gemiddelde engagementscore dan zomaar doortrekken naar de volledige organisatie? Misschien zijn kantoormedewerkers gemiddeld meer tevreden dan hun operationele collega's. In dat geval kan de scheve verdeling een vertekend beeld geven van het engagement binnen jouw organisatie.
geschreven door Lotte Van der Sijpt.
Gelukkig bestaan er statistische technieken om zulke verschillen aan te pakken. Maar wanneer is corrigeren eigenlijk nodig? En kies je dan best voor weging of resampling?
In deze blog geven we je een concreet stappenplan mee om de representativiteit van je HR-data te beoordelen. We lichten verder toe welke methodes je kan gebruiken om scheve verdelingen te corrigeren en waar je rekening mee moet houden om betrouwbare conclusies te trekken.
Wanneer moet je jouw HR-data representatiever maken?
Een scheve verdeling in jouw survey betekent niet automatisch dat jouw resultaten onbetrouwbaar zijn. De belangrijkste vraag is of de verschillen tussen jouw respondenten en jouw volledige personeelsbestand (= de populatie die je wilt onderzoeken) jouw conclusies kunnen vertekenen.
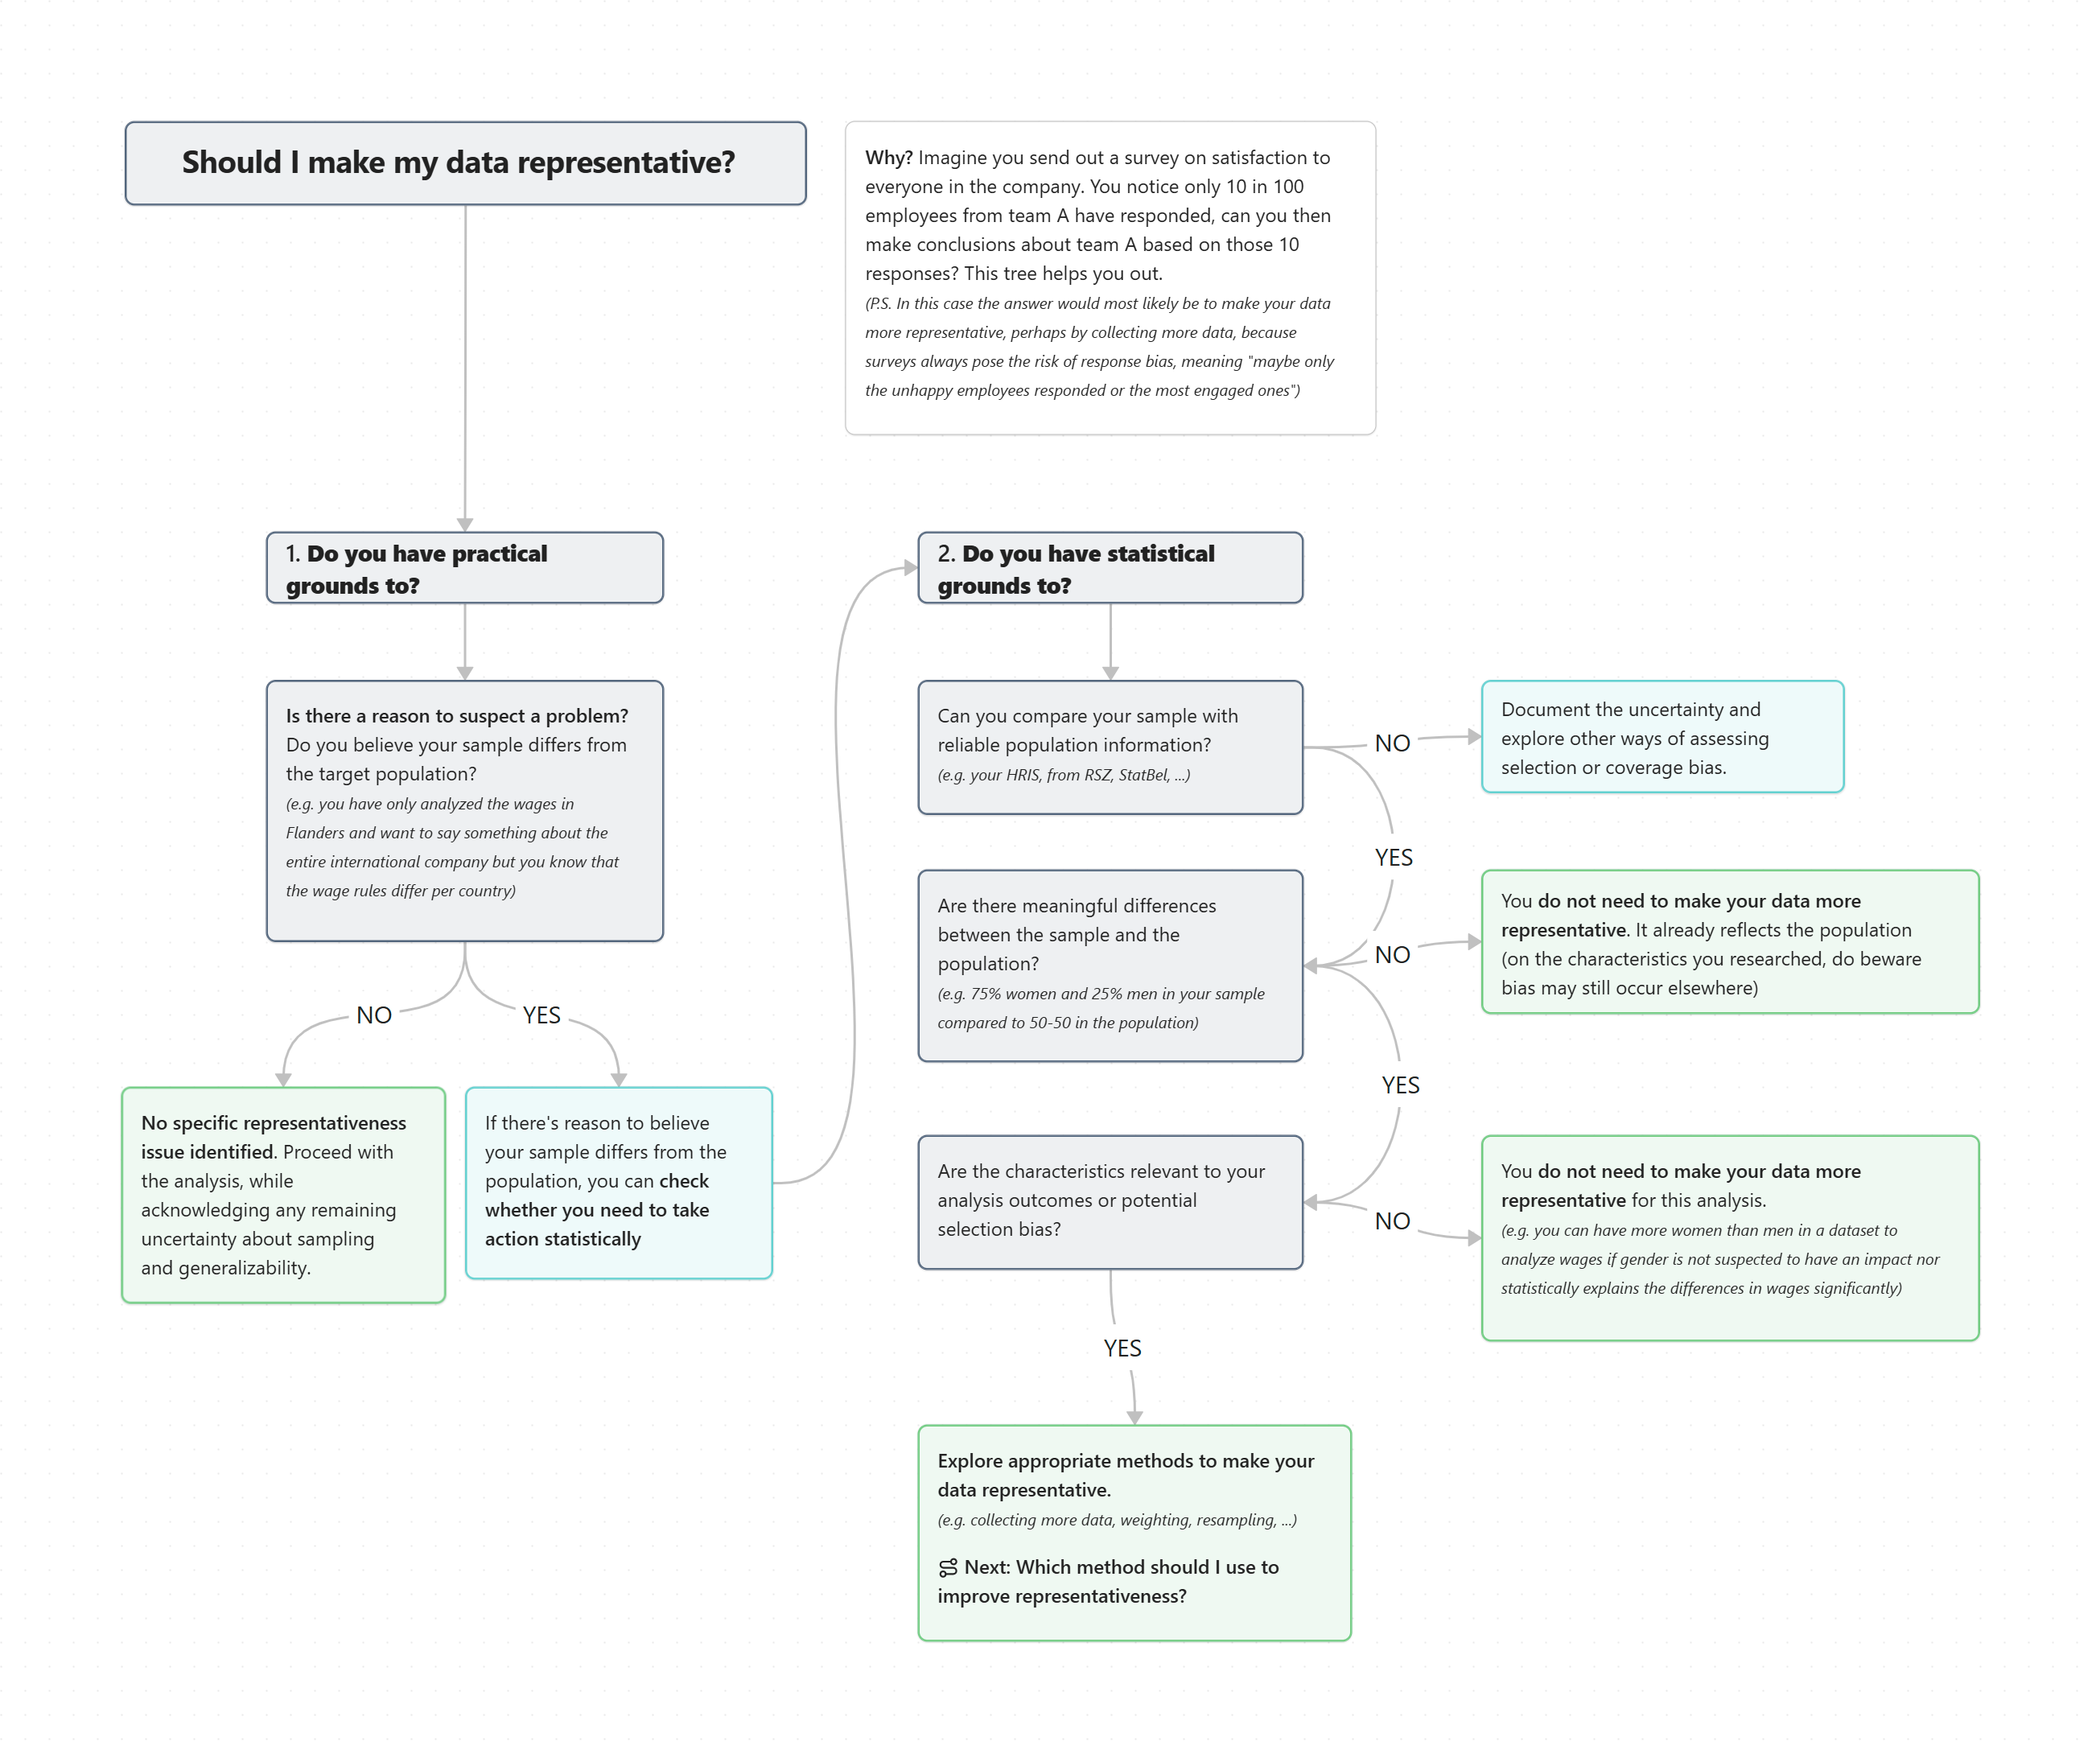
Om dat te beoordelen, kan je ons onderstaande stroomschema gebruiken, of jezelf de volgende drie vragen stellen:
1. Heb je een reden om te vermoeden dat je steekproef afwijkt van je populatie (= volledige organisatie)?
Begin met jouw kennis van de organisatie. Zijn bepaalde afdelingen, functiegroepen of leeftijdscategorieën opvallend minder vertegenwoordigd? Misschien weet je bijvoorbeeld dat arbeiders minder gemakkelijk toegang hebben tot de survey, omdat ze niet dagelijks achter een computer zitten.
Heb je geen concrete aanwijzingen voor een probleem? Dan kan je doorgaans verder met jouw analyse, zolang je voorzichtig blijft met conclusies over de volledige organisatie.
2. Kan je die verschillen aantonen met populatiegegevens?
Vergelijk de samenstelling van jouw respondenten met die van jouw volledige personeelsbestand. Hiervoor kan je bijvoorbeeld jouw HR-systeem gebruiken.
In ons voorbeeld bestaat de organisatie voor 55% uit bedienden, terwijl zij 80% van de respondenten vertegenwoordigen. Dat is een duidelijk verschil. Zonder betrouwbare populatiegegevens kan je zulke afwijkingen moeilijk vaststellen of corrigeren.
3. Zijn de verschillen relevant voor wat je wil onderzoeken?
Niet elke afwijking heeft invloed op je resultaten. Stel dat vrouwen oververtegenwoordigd zijn in een survey, maar dat engagement nauwelijks verschilt tussen mannen en vrouwen. Dan hoeft die scheve verdeling niet noodzakelijk tot een vertekend engagementcijfer te leiden.
Bij ons voorbeeld is het daarentegen goed mogelijk dat arbeiders en bedienden andere ervaringen hebben met hun werk, leidinggevenden of arbeidsomstandigheden. De ongelijke vertegenwoordiging kan dus wel degelijk invloed hebben op de gemiddelde engagementscore.
Zijn er relevante verschillen tussen jouw steekproef en populatie? Dan is het zinvol om te onderzoeken of je de data representatiever kan maken. Dat kan bijvoorbeeld door extra antwoorden te verzamelen of statistische technieken zoals weging toe te passen.
Methode 1 – Weging: Niet elke respondent telt even zwaar mee
Een eerste manier om een scheve verdeling te corrigeren, is weging. Hierbij behoud je alle antwoorden uit jouw survey, maar geef je sommige respondenten meer gewicht dan andere.
In ons voorbeeld zijn bedienden oververtegenwoordigd: ze vormen 80% van de respondenten, terwijl ze slechts 55% van het personeelsbestand uitmaken. Bij arbeiders is het omgekeerd: zij vertegenwoordigen 45% van de organisatie, maar slechts 20% van de respondenten.
Om hiervoor te corrigeren, berekenen we per groep een gewicht: Gewicht = aandeel in de populatie ÷ aandeel in de steekproef
| Groep | Populatie | Respondenten | Gewicht |
|---|---|---|---|
| Bedienden | 55% | 80% | 0,69 |
| Arbeiders | 45% | 20% | 2,25 |
Wat betekent dit concreet? Bij het berekenen van de gemiddelde engagementscore telt het antwoord van een bediende voortaan voor ongeveer 0,69 mee, terwijl dat van een arbeider voor 2,25 meetelt. Zo krijgen beide groepen opnieuw een invloed die aansluit bij hun werkelijke aandeel in de organisatie.
Stel bijvoorbeeld dat bedienden gemiddeld 7,5 op 10 scoren op engagement, tegenover 6,5 bij arbeiders.
Zonder weging bedraagt de gemiddelde engagementscore 7,3 op 10. Na weging wordt dat 7,05 op 10. Een verschil van 0,25 punten, zonder dat er ook maar één antwoord veranderd is.
Weging kan dus helpen om een representatiever beeld te krijgen van jouw organisatie, op voorwaarde dat je over betrouwbare populatiegegevens beschikt en de kenmerken waarop je weegt relevant zijn voor je onderzoek.
Let wel: weging lost niet alles op. Als bijvoorbeeld vooral tevreden arbeiders de survey hebben ingevuld, kan hun engagementscore nog steeds vertekend zijn. Door hun antwoorden zwaarder mee te tellen, verdwijnt die vertekening niet automatisch. Je corrigeert immers voor de verschillen die je kent en meet. Niet voor alle mogelijke redenen waarom medewerkers wel of niet deelnamen.
Methode 2 – resampling: Een andere steekproef samenstellen
Een tweede mogelijkheid is resampling. Waar we bij weging alle antwoorden behouden en hun invloed aanpassen, werken we hier met een nieuwe selectie van antwoorden uit onze bestaande dataset.
Keren we terug naar ons voorbeeld. Van de 150 respondenten zijn er 120 bedienden (80%) en 30 arbeiders (20%). Maar in de volledige organisatie is de verhouding 55% bedienden en 45% arbeiders.
Met gestratificeerde resampling kunnen we een nieuwe steekproef samenstellen die beter aansluit bij die werkelijke verhouding. Stel dat we een steekproef van 100 antwoorden willen samenstellen:
- We selecteren willekeurig 55 antwoorden van bedienden.
- We selecteren 45 antwoorden van arbeiders. Omdat slechts 30 arbeiders deelnamen, moeten we sommige antwoorden meerdere keren selecteren. Dat noemen we oversampling met teruglegging.
Zo krijgen we een nieuwe dataset waarin de verhouding tussen bedienden en arbeiders overeenkomt met die van de organisatie.
Maar wat is dan het verschil met weging? Bij weging gebruiken we alle 150 oorspronkelijke antwoorden, maar tellen sommige zwaarder mee. Bij resampling veranderen we de samenstelling van de dataset door antwoorden opnieuw te selecteren. Sommige medewerkers komen daardoor meerdere keren voor, terwijl andere mogelijk niet geselecteerd worden.
Resampling kan nuttig zijn wanneer je een dataset met een bepaalde groepsverdeling nodig hebt. Bijvoorbeeld voor een simulatie of een specifieke analysetechniek. Maar het is niet automatisch de beste oplossing om een gemiddelde engagementscore te berekenen. Daarvoor is weging doorgaans eenvoudiger en efficiënter, omdat je geen oorspronkelijke antwoorden hoeft weg te laten.
Let ook hier op: door dezelfde antwoorden vaker te selecteren, verzamel je geen nieuwe informatie. Je hebt nog altijd maar 30 unieke antwoorden van arbeiders. Bovendien maakt een gewone bootstrap, waarbij je willekeurig opnieuw trekt uit de bestaande steekproef, een scheve verdeling niet vanzelf representatief. Daarvoor moet je bij het hertrekken bewust rekening houden met de werkelijke populatieverhoudingen.
Hoe kan je bepaalde valkuilen concreet aanpakken?
Weging en resampling kunnen helpen om scheve verdelingen in jouw HR-data te corrigeren. Maar soms bots je tijdens die correctie op nieuwe uitdagingen. Gelukkig bestaan er ook daarvoor oplossingen.
1. Sommige groepen zijn nauwelijks vertegenwoordigd
Stel dat slechts vijf arbeiders jouw survey hebben ingevuld. Bij weging zouden die vijf antwoorden een bijzonder groot gewicht kunnen krijgen. Bij resampling zouden dezelfde antwoorden dan weer heel vaak terugkomen. In beide gevallen wordt jouw resultaat sterk afhankelijk van een handvol medewerkers.
Wat kan je doen?
- Verzamel extra antwoorden bij de ondervertegenwoordigde groep, bijvoorbeeld via gerichte herinneringen of een toegankelijker afnamekanaal.
- Voeg kleine groepen samen in de rapportage als dat inhoudelijk verantwoord is en de groepen voldoende vergelijkbaar zijn.
- Rapporteer voorzichtig wanneer extra dataverzameling niet mogelijk is. Vermijd bijvoorbeeld afzonderlijke conclusies over groepen met zeer weinig respondenten (N < 10).
2. Sommige respondenten krijgen een te groot gewicht (> 3)
Stel dat je na de berekening merkt dat bepaalde respondenten een gewicht van 4,5 krijgen. Hun antwoorden tellen dan 4,5 keer zo zwaar mee als een antwoord met gewicht 1. Daardoor kunnen enkele respondenten een onevenredig grote invloed krijgen op jouw resultaten.
Wat kan je doen?
- Controleer de verdeling van jouw gewichten. Een gewicht groter dan drie keer het gemiddelde gewicht kan bijvoorbeeld een aanleiding zijn om verder te kijken.
- Pas weight trimming toe: begrens uitzonderlijk hoge gewichten om te vermijden dat enkele antwoorden te veel invloed krijgen.
- Controleer opnieuw de representativiteit na het begrenzen. Door gewichten aan te passen, kan jouw steekproef namelijk opnieuw wat afwijken van de werkelijke populatieverdeling.
3. Jouw steekproef wijkt af op meerdere kenmerken tegelijk
Stel dat je de verhouding tussen arbeiders en bedienden hebt gecorrigeerd, maar daarna ontdekt dat ook jonge medewerkers en bepaalde afdelingen ondervertegenwoordigd zijn. Wegen op één kenmerk is dan mogelijk niet voldoende.
Wat kan je doen?
- Gebruik post-stratificatie: verdeel respondenten in gecombineerde groepen, bijvoorbeeld op basis van functiecategorie én leeftijd, en bereken voor elke groep een gewicht. Hiervoor heb je wel voldoende respondenten per groep nodig.
- Gebruik raking (iterative proportional fitting): deze techniek past gewichten stapsgewijs aan zodat de steekproef aansluit bij meerdere bekende populatieverdelingen, bijvoorbeeld die van functiecategorie, leeftijd en afdeling. Je hoeft daarvoor niet noodzakelijk de exacte verdeling van alle combinaties te kennen.
- Kies relevante kenmerken: corrigeer vooral voor kenmerken die samenhangen met de kans om deel te nemen en mogelijk ook met de uitkomst die je onderzoekt.
Take-away
Welke methode je ook kiest: statistische correcties kunnen alleen rekening houden met informatie die je hebt. Als bijvoorbeeld vooral ontevreden medewerkers niet deelnemen, maar je dat nergens kan vaststellen, blijft vertekening mogelijk.
Een goede survey begint daarom nog altijd bij een goede dataverzameling.
Meer weten?
Wil jij ook meer inzichten halen over het engagement in jouw organisatie? Schrijf je dan zeker in voor onze tweemaandelijkse nieuwsbrief met tips en trends over HR-analytics of contacteer ons.